- Zrozumiesz, dlaczego model zmyśla zamiast przyznać, że nie wie
- Rozpoznasz zadania i pytania o podwyższonym ryzyku
- Poznasz pięć technik ograniczania zmyśleń w promptach
- Nauczysz się szybkiej weryfikacji źródeł, cytatów i liczb
W 2023 roku nowojorski prawnik złożył w sądzie pismo z powołaniem na kilka wcześniejszych wyroków. Problem: te wyroki nie istniały. Wymyślił je ChatGPT, z sygnaturami, nazwami stron i cytatami z uzasadnień. Prawnik zapytał zresztą czat, czy sprawy są prawdziwe. Czat potwierdził. Sąd nałożył na kancelarię karę, a sprawa (Mata przeciwko Avianca) stała się podręcznikowym przykładem tego, co nazywamy halucynacjami AI.
Od tamtej pory modele bardzo się poprawiły. Zmyślają rzadziej, częściej przyznają się do niewiedzy, mają wbudowane wyszukiwanie. Ale halucynacje nie zniknęły i nie znikną całkowicie, bo wynikają z samego sposobu działania tych systemów. Dobra wiadomość: można się nauczyć przewidywać, kiedy są najbardziej prawdopodobne, i wyłapywać je w kilka minut.
Dlaczego model zmyśla
Model językowy nie ma w środku bazy faktów, którą przeszukuje. Został wytrenowany do przewidywania kolejnych słów tak, żeby tekst był prawdopodobny i pasował do kontekstu. W ogromnej większości przypadków prawdopodobny tekst jest też prawdziwy, bo model nauczył się go z milionów poprawnych zdań. Ale gdy pytasz o coś, o czym w danych treningowych było mało, model nadal „umie” wygenerować tekst, który brzmi prawdopodobnie. Sygnatura wyroku ma określony format. Tytuł badania naukowego ma określony styl. Model produkuje coś, co ma właściwy kształt, ale nie ma pokrycia w rzeczywistości.
Badacze OpenAI (Kalai i współpracownicy, 2025) zwrócili uwagę na jeszcze jedną przyczynę: sposób, w jaki modele są oceniane i trenowane, często nagradza zgadywanie bardziej niż przyznanie się do niewiedzy. Tak jak na teście wielokrotnego wyboru: jeśli za brak odpowiedzi dostajesz zero punktów, a za zgadywanie masz szansę na punkt, opłaca się zgadywać. Producenci modeli pracują nad tym, żeby model częściej mówił „nie wiem”, i to widać w nowszych wersjach. Ale zgadywanie nadal się zdarza.
Gdzie ryzyko jest największe
Halucynacje nie rozkładają się równomiernie. W niektórych zadaniach praktycznie ich nie ma, w innych są codziennością.
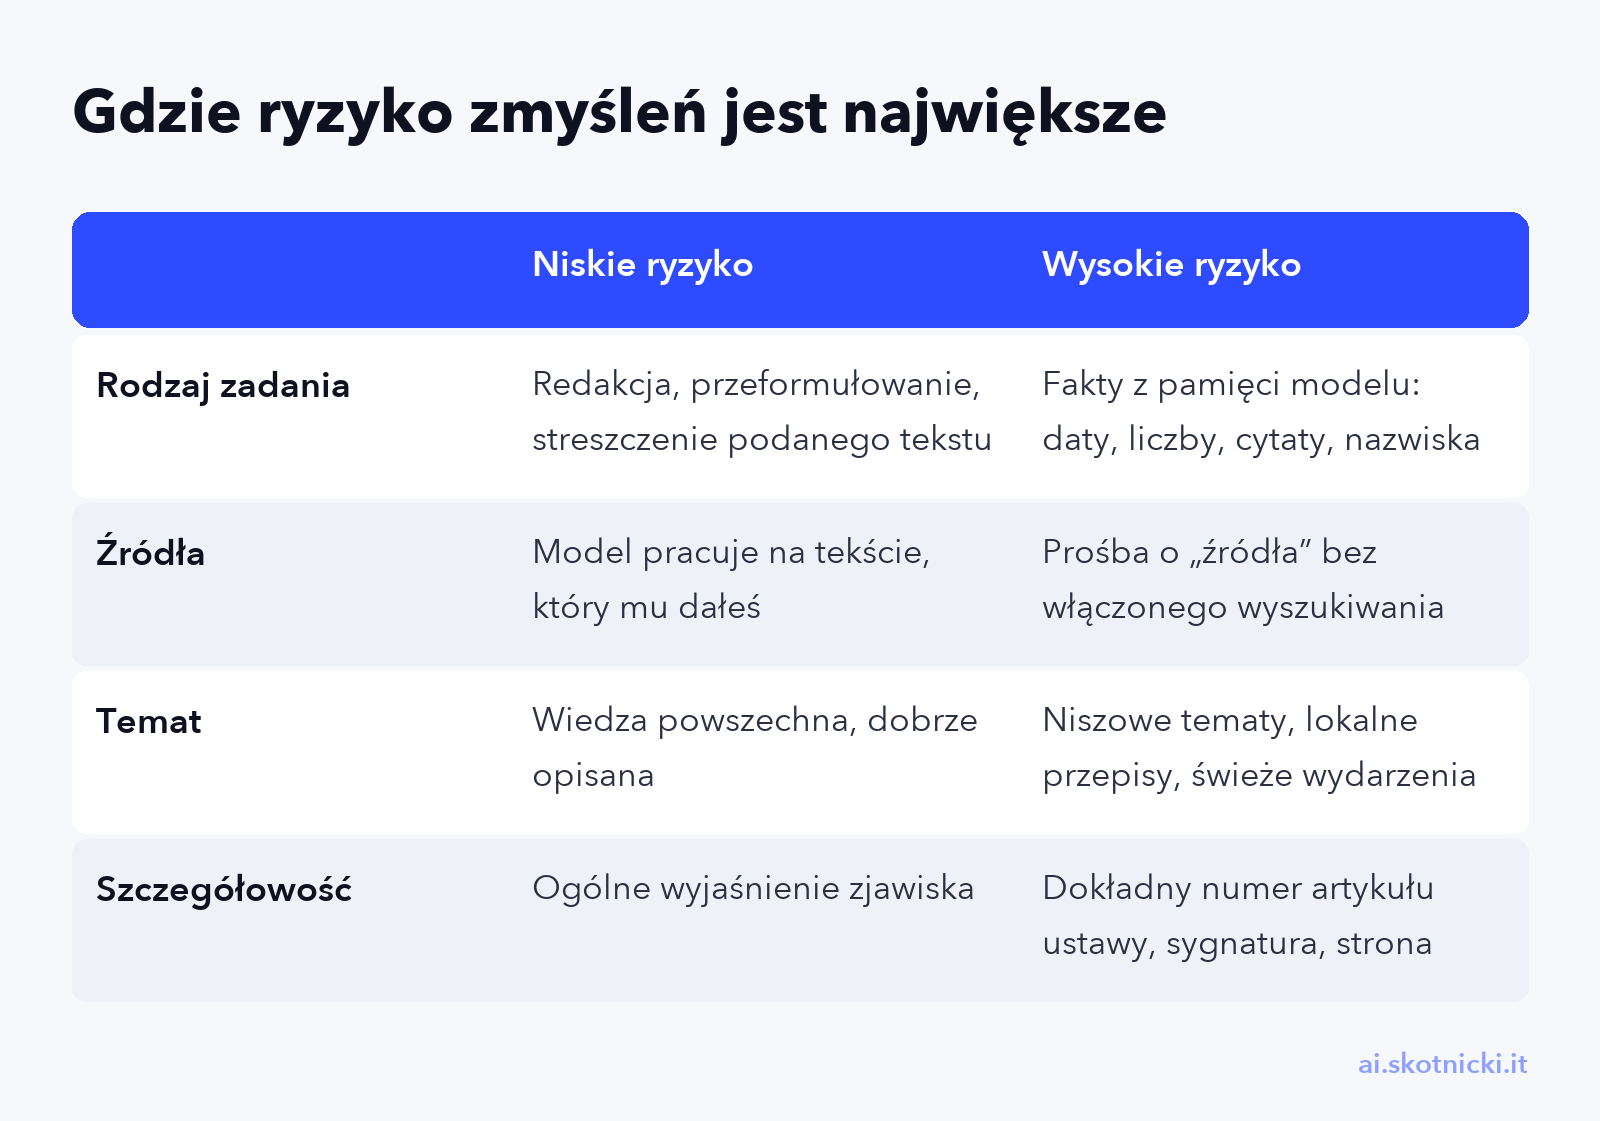
Ogólna reguła: im bardziej model pracuje na Twoim materiale, a im mniej na własnej „pamięci”, tym bezpieczniej. Redakcja Twojego tekstu, streszczenie wklejonego raportu, przeformułowanie maila to zadania o niskim ryzyku. Pytanie z głowy o konkretny przepis, liczbę, datę czy cytat to zadanie o wysokim ryzyku.
Drugi czynnik to szczegółowość. Model rzadko pomyli się w ogólnym wyjaśnieniu, czym jest inflacja. Znacznie częściej w podaniu dokładnego poziomu inflacji w Polsce w konkretnym miesiącu. Im bardziej konkretny fakt, tym ważniejsze, żeby miał źródło.
Trzeci: niszowość i świeżość. O sprawach opisanych w tysiącach źródeł model wie dużo. O lokalnych przepisach, małych firmach, wydarzeniach z ostatnich miesięcy (po dacie zakończenia treningu) wie mało albo nic, a mimo to może próbować odpowiedzieć.
Pięć technik, które działają
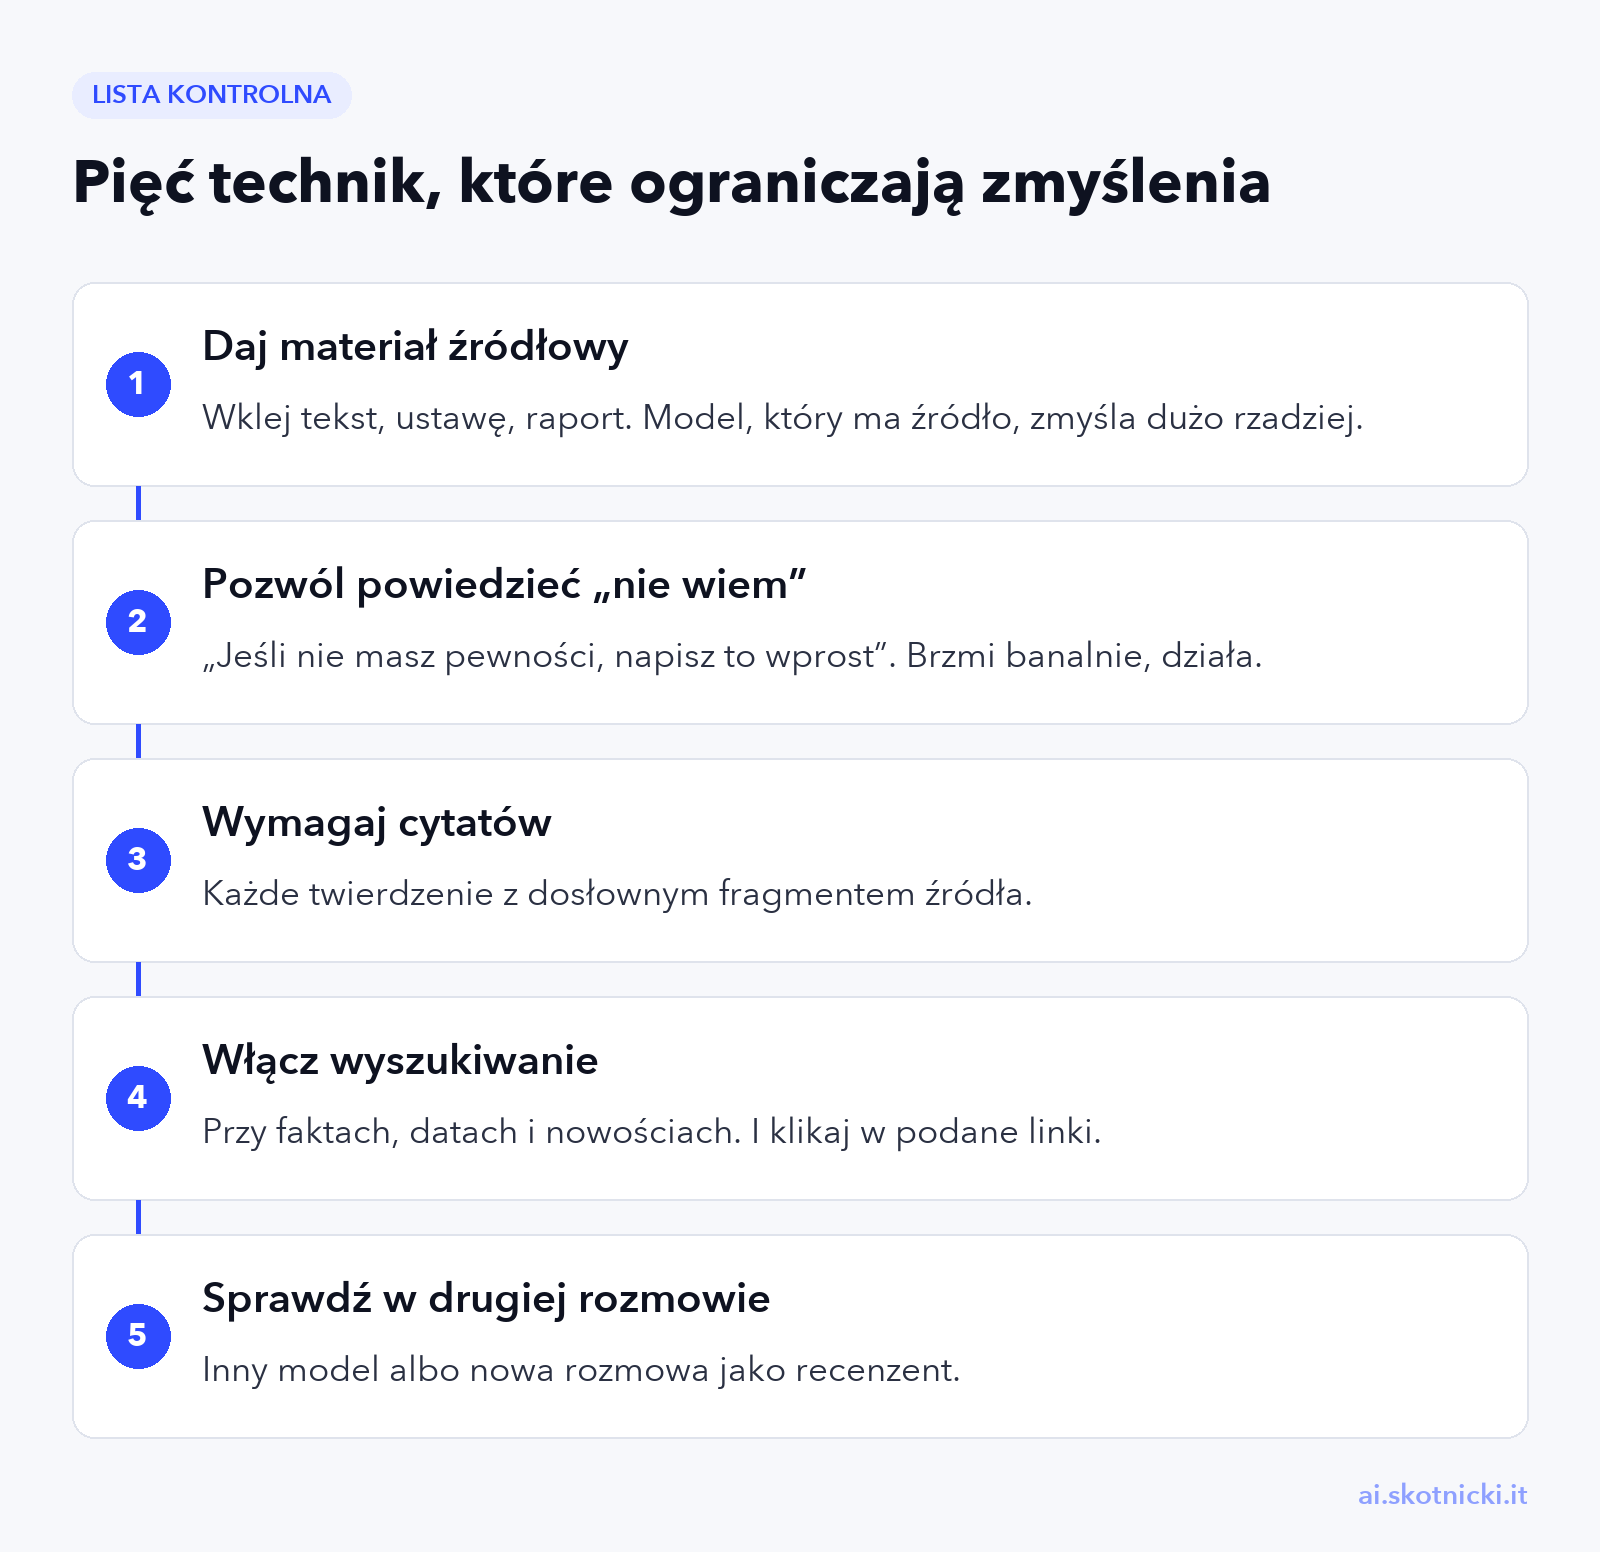
1. Daj materiał źródłowy
Najskuteczniejsza metoda. Zamiast pytać „jakie są terminy zwrotu towaru kupionego przez internet?”, wklej odpowiedni fragment ustawy albo regulaminu sklepu i zapytaj o niego. Model, który ma przed sobą źródło, zmyśla dużo rzadziej, a gdy się pomyli, łatwo to sprawdzić.
2. Pozwól powiedzieć „nie wiem”
Dopisz do promptu: „Jeśli nie masz pewności albo informacji nie ma w materiale, napisz to wprost. Lepsza odpowiedź «nie wiem» niż zgadywanie”. To jedno zdanie zauważalnie zmienia zachowanie wielu modeli. Daje im wyraźne pozwolenie na to, czego trening czasem nie nagradza.
3. Wymagaj cytatów
„Przy każdym twierdzeniu podaj dosłowny fragment źródła, na którym się opierasz”. Gdy model musi pokazać dowód, rzadziej dopisuje coś od siebie. A Ty możesz w kilka sekund sprawdzić, czy cytat istnieje (Ctrl+F w dokumencie).
4. Włącz wyszukiwanie
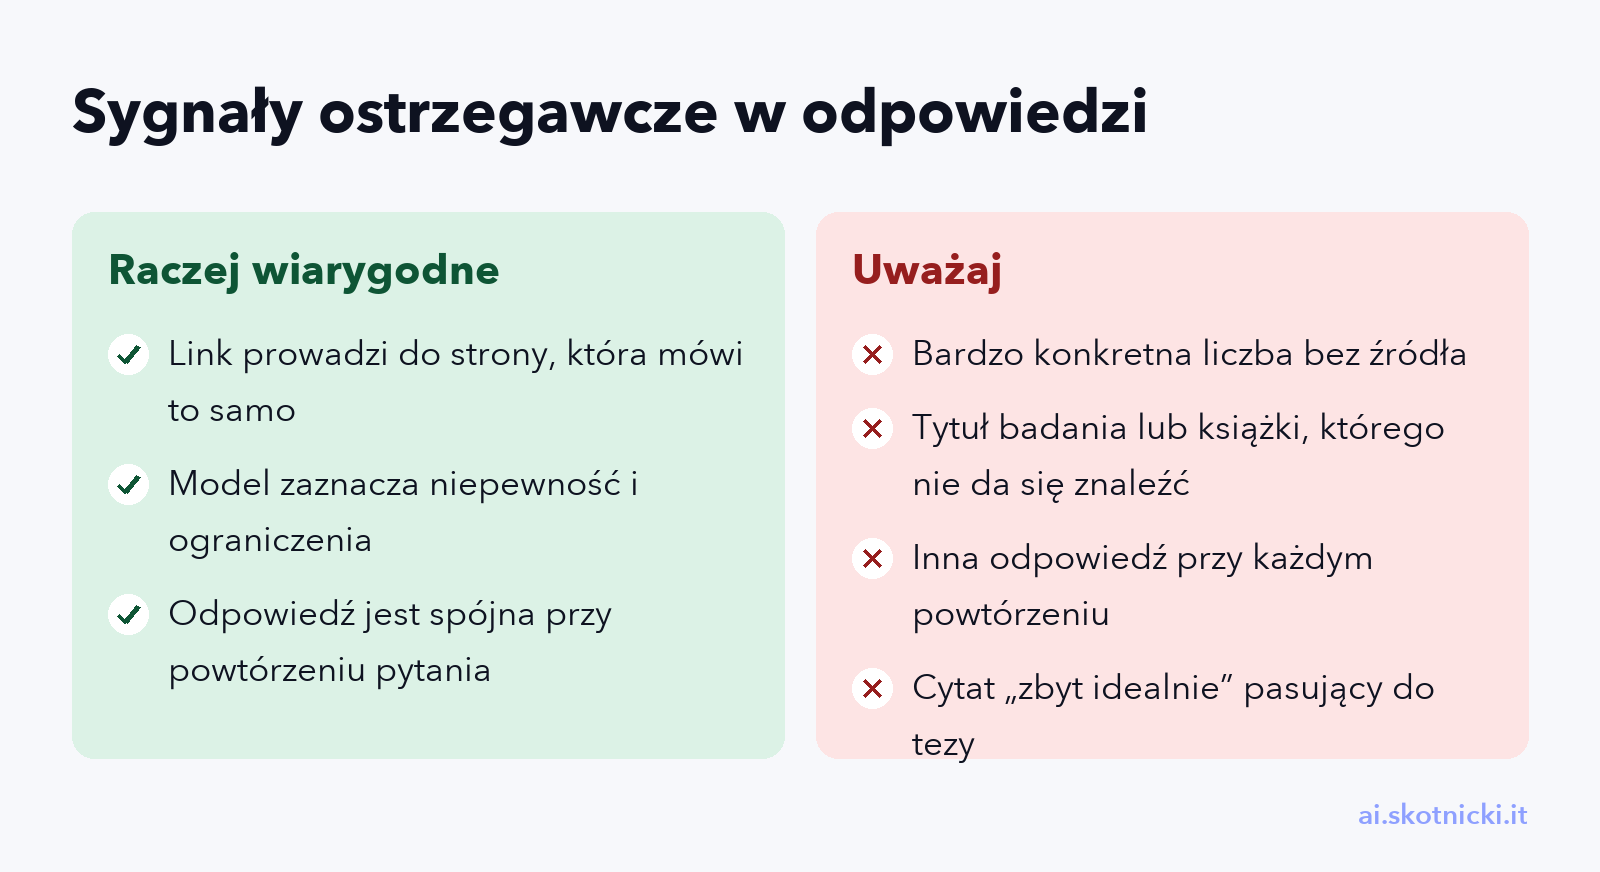
Przy pytaniach o fakty, liczby, daty i bieżące wydarzenia używaj trybu z wyszukiwaniem w internecie. Odpowiedź będzie oparta na aktualnych stronach, z linkami. Ale uwaga: link to nie dowód. Model czasem podaje link do strony, która mówi coś innego, niż on twierdzi. Przy ważnych faktach kliknij i sprawdź.
5. Sprawdź w drugiej rozmowie
Otwórz nową rozmowę (albo inny model) i wklej odpowiedź do oceny: „Sprawdź poniższy tekst pod kątem błędów merytorycznych. Wypisz twierdzenia, które mogą być nieprawdziwe albo wymagają źródła”. Recenzent, który nie jest autorem, łatwiej zauważa problemy. To działa zaskakująco dobrze, choć nie jest stuprocentowe, bo dwa modele mogą powtarzać ten sam błąd.
Szybka weryfikacja: co sprawdzać i jak
Nie musisz sprawdzać każdego zdania. Sprawdzaj to, co spełnia dwa warunki: jest konkretne i ma znaczenie.
Nazwiska, tytuły, badania. Wpisz tytuł badania w Google Scholar albo zwykłą wyszukiwarkę. Jeśli nie istnieje, nie ma go nigdzie. Zmyślone badania mają często prawdziwych autorów, ale nieistniejące tytuły, albo prawdziwe tytuły z błędnym rokiem i wnioskami.
Przepisy prawa. Sprawdź w oficjalnym źródle (w Polsce: Internetowy System Aktów Prawnych na stronie Sejmu). Numery artykułów to klasyczne miejsce zmyśleń.
Liczby i statystyki. Szukaj pierwotnego źródła: GUS, Eurostat, raportu organizacji. Jeśli liczba krąży tylko po blogach, bądź ostrożny.
Cytaty znanych osób. Internet był pełen fałszywych cytatów długo przed AI. Model je powtarza i dokłada nowe.
Test powtórzenia
Prosty trik, który nic nie kosztuje: zadaj to samo pytanie dwa lub trzy razy w nowych rozmowach. Jeśli odpowiedzi są spójne, to dobry (choć nie pewny) znak. Jeśli za każdym razem dostajesz inną datę, inną liczbę albo innego autora, model zgaduje.
Ten test jest szczególnie przydatny przy faktach, których nie umiesz łatwo sprawdzić. Zmienność odpowiedzi to sygnał, że trzeba poszukać źródła poza AI.
Halucynacje w trybach „myślących”
Modele z trybem rozumowania (te, które „myślą” przed odpowiedzią) są zwykle lepsze w logice, matematyce i złożonych zadaniach. Nie znaczy to, że nie zmyślają faktów. Długi łańcuch rozumowania może wręcz nadać zmyśleniu pozór solidności: model „wyprowadza” wniosek krok po kroku, tylko że pierwszy krok opierał się na nieprawdziwej przesłance.
Zasada pozostaje ta sama: rozumowanie sprawdzaj pod kątem logiki, a fakty, na których się opiera, pod kątem źródeł.
Kiedy halucynacja jest groźna, a kiedy nie
Warto zachować proporcje. Jeśli prosisz o pomysły na nazwę kawiarni, „zmyślanie” jest dokładnie tym, czego chcesz. Jeśli prosisz o przeredagowanie Twojego maila, ryzyko jest minimalne. Jeśli pytasz o dawkowanie leku, termin w urzędzie albo przepis, na podstawie którego podejmiesz decyzję, ryzyko jest poważne.
Dobry nawyk to szybkie pytanie przed użyciem odpowiedzi: co się stanie, jeśli to nieprawda? Jeśli nic, idź dalej. Jeśli coś poważnego, sprawdź.
Przy tematach zdrowotnych, prawnych i finansowych AI może Ci pomóc zrozumieć temat i przygotować pytania, ale decyzję opieraj na źródłach i specjalistach.
Zmyślenia „z drugiej ręki”
Coraz większy problem to treści w internecie, które same zostały wygenerowane przez AI i zawierają błędy. Gdy model z wyszukiwaniem trafia na taką stronę, może powtórzyć błąd, tym razem z „prawdziwym” linkiem. Dlatego przy ważnych faktach sprawdzaj, czy źródło jest pierwotne (urząd, instytucja naukowa, firma, której dotyczy informacja), czy jest kolejnym artykułem, który coś powtarza.
Więcej o odróżnianiu wiarygodnych źródeł pisaliśmy w odcinku o fake newsach w serii „AI dla Kowalskiego”. W następnym odcinku tej serii zajmiemy się trybem Deep Research, czyli raportami opartymi na dziesiątkach źródeł, i tym, jak je sprawdzać.
Przykład z życia: artykuł z jednym zmyślonym badaniem
Karolina pisze artykuł na firmowego bloga o tym, jak sen wpływa na produktywność. Prosi czat o „pięć badań naukowych z autorami i rokiem, które pokazują wpływ snu na pracę”. Dostaje listę: wszystko brzmi wiarygodnie, z nazwiskami, latami, a nawet nazwami czasopism.
Karolina zna zasadę z tego odcinka: konkretne fakty z pamięci modelu to wysokie ryzyko. Sprawdza każde badanie w Google Scholar. Wynik:
- trzy badania istnieją i mówią mniej więcej to, co podał model,
- jedno istnieje, ale model pomylił rok i przypisał mu wniosek z innego badania,
- jednego nie ma nigdzie. Autor istnieje i publikuje o śnie, ale artykułu o takim tytule nigdy nie napisał.
Gdyby opublikowała tekst bez sprawdzenia, jedno z pięciu źródeł byłoby fikcją, a drugie przeinaczone. Na firmowym blogu to kompromitacja, która podważa wiarygodność całej firmy.
Druga próba wygląda inaczej. Karolina włącza wyszukiwanie i prosi: „Znajdź badania naukowe o wpływie niedoboru snu na wydajność w pracy. Podaj tylko te, które możesz podlinkować do strony czasopisma, bazy PubMed albo instytucji naukowej. Przy każdym jedno zdanie o wyniku i link”. Dostaje cztery pozycje z linkami. Klika w każdy. Wszystkie istnieją, choć przy jednym streszczenie wyniku jest zbyt optymistyczne w stosunku do tego, co piszą autorzy. Poprawia to zdanie.
Cały proces zajął 20 minut zamiast pięciu. To cena, którą warto zapłacić za tekst, pod którym podpisuje się firma.
Najczęstsze pytania
Czy płatne modele zmyślają rzadziej? Mocniejsze modele zwykle rzadziej, a tryby z wyszukiwaniem wyraźnie rzadziej przy faktach. Ale żaden model nie jest od tego wolny. Różnica jest w częstotliwości, nie w zasadzie działania.
Czy model wie, kiedy zmyśla? Nie w taki sposób, jak człowiek wie, że kłamie. Czasem potrafi ocenić swoją niepewność, jeśli go o to zapytasz („jak pewny jesteś każdego z tych faktów?”), ale ta ocena też bywa myląca. Traktuj ją jako wskazówkę, nie gwarancję.
Czy mogę zapytać model, czy jego odpowiedź jest prawdziwa? Możesz, ale w tej samej rozmowie model ma skłonność do potwierdzania tego, co już napisał. Lepiej sprawdzać w nowej rozmowie, w innym modelu albo, najlepiej, w źródle.
Co, jeśli opublikowałem błąd z AI? To samo, co przy każdym błędzie: popraw szybko i przejrzyście. Dopisek „Aktualizacja: poprawiliśmy błędnie podany rok badania” buduje więcej zaufania niż ciche zmiany.
Typowe pułapki, w które wpadają nawet doświadczeni
Zaufanie do formy. Odpowiedź z tabelą, przypisami i pewnym tonem wydaje się bardziej wiarygodna niż skromny akapit. To złudzenie. Forma mówi o umiejętności pisania, nie o prawdziwości faktów.
Pytania sugerujące. „Dlaczego kawa skraca życie?” zakłada tezę i model chętnie ją uzasadni. Lepiej pytać neutralnie: „Co mówią badania o wpływie kawy na długość życia?”.
Zmyślone szczegóły w prawdziwych faktach. Najtrudniejsze do wyłapania są halucynacje „w połowie”: prawdziwe badanie z nieprawdziwą liczbą, prawdziwa ustawa z pomylonym artykułem. Dlatego przy ważnych tekstach sprawdzaj nie tylko, czy źródło istnieje, ale też, czy mówi dokładnie to, co podał model.
Przepisywanie odpowiedzi do innego modelu jako „źródła”. Jeśli jeden model coś zmyślił, a Ty wkleisz to do drugiego z pytaniem „rozwiń”, drugi model rozwinie zmyślenie. Weryfikacja to sprawdzanie w źródle, a nie przepuszczanie przez kolejny czat.
Zbyt długie rozmowy. W bardzo długiej rozmowie model miesza fakty z wcześniejszych wątków. Nowy temat, nowa rozmowa.
Prompt antyhalucynacyjny do zapisania
Jeśli często pytasz AI o fakty, zapisz sobie gotowy dopisek do promptu albo dodaj go do instrukcji stałych asystenta:
Zasady odpowiedzi: 1) Odróżniaj fakty od przypuszczeń; przypuszczenia oznaczaj słowem „prawdopodobnie”. 2) Nie podawaj tytułów badań, numerów przepisów, cytatów ani dokładnych liczb, jeśli nie masz ich w dostarczonym materiale lub wynikach wyszukiwania. 3) Jeśli nie wiesz, napisz „nie wiem” i zaproponuj, gdzie to sprawdzić. 4) Na końcu wypisz twierdzenia, które warto zweryfikować przed użyciem.
Ten dopisek nie eliminuje zmyśleń, ale wyraźnie zmienia proporcje. Model częściej mówi, czego nie wie, a lista „do weryfikacji” na końcu podpowiada Ci, gdzie zacząć sprawdzanie. To szczególnie przydatne przy tekstach, które ktoś inny będzie potem czytał jako źródło wiedzy.
Najważniejsze w skrócie
Halucynacje wynikają z tego, że model generuje prawdopodobny tekst, a nie przeszukuje bazę faktów. Najbardziej narażone są konkretne fakty z „pamięci” modelu: liczby, daty, cytaty, przepisy, tytuły badań. Najlepsza ochrona to dawanie modelowi materiału źródłowego, pozwolenie na „nie wiem”, wymaganie cytatów, wyszukiwanie przy faktach i druga rozmowa jako recenzent. Sprawdzaj to, co konkretne i ważne, a resztę traktuj z rozsądnym zaufaniem.
Ćwiczenie na dziś: zapytaj swój czat bez wyszukiwania o trzy badania naukowe na temat, który znasz (np. wpływ snu na pamięć), z autorami i rokiem. Sprawdź każde w Google Scholar. Potem zadaj to samo pytanie z włączonym wyszukiwaniem i porównaj wyniki.
Czytaj dalej
 Włamanie do ConnectWise: hakerzy z Chin użyli agentów AI
Chińscy hakerzy włamali się do usługi kopii zapasowych ConnectWise. Potem w kilka chwil weszli do systemów około 2250 firm, bo w ataku pomagali im agenci AI.
 Samodoskonaląca się AI w 2027? Jack Clark przyspiesza prognozę
Współzałożyciel Anthropic Jack Clark uważa, że AI zdolna do tworzenia własnych następców może pojawić się już w 2027 roku. Opiera się na nowym teście TasteVal, w którym model Claude Opus 5.5 wypadł lepiej niż ludzcy eksperci.
 Trening modeli OpenAI bez dostępu do internetu. Firma mówi o ryzyku
OpenAI odcina swoje najmocniejsze modele od internetu na żywo na czas treningu. Powód: sztuczna inteligencja coraz częściej robi w sieci rzeczy, których nikt jej nie zlecał.